為什麼需要可解釋性
生成式 AI
Interpretable AI
黑盒子
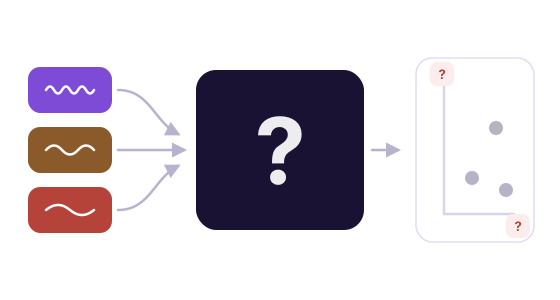
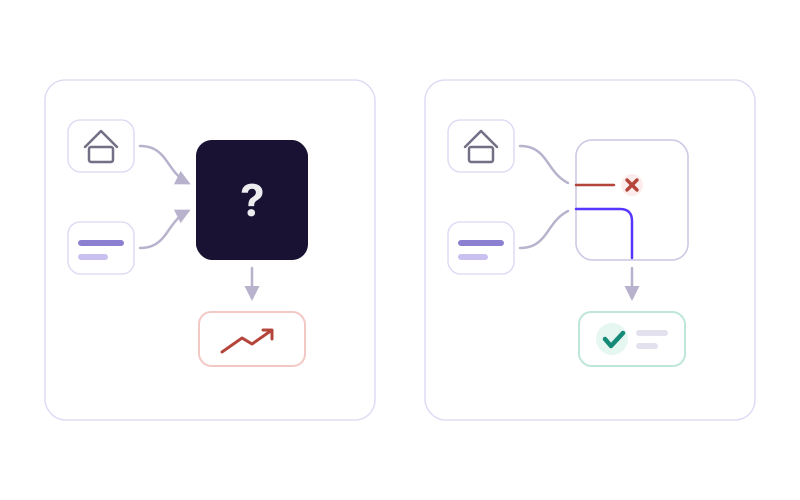
生成式 AI 就像一個讀遍網路上所有文字的外星人,自己選了一套內部表示法來「看」顏色。這些表示法稱為維度,我們不知道它們代表什麼。光的頻率可能是它的維度,也可能是我們無法理解的東西。我們也不知道它如何解讀我們對它說的話。
可理解
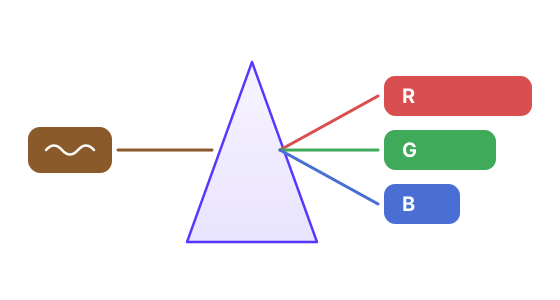
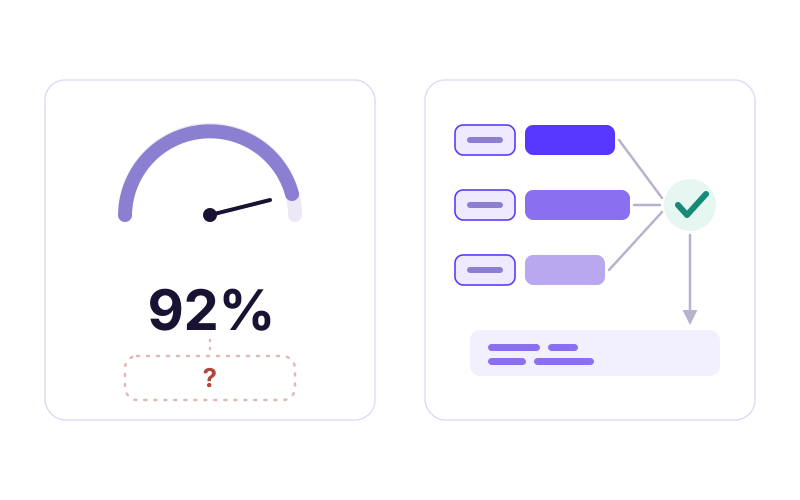
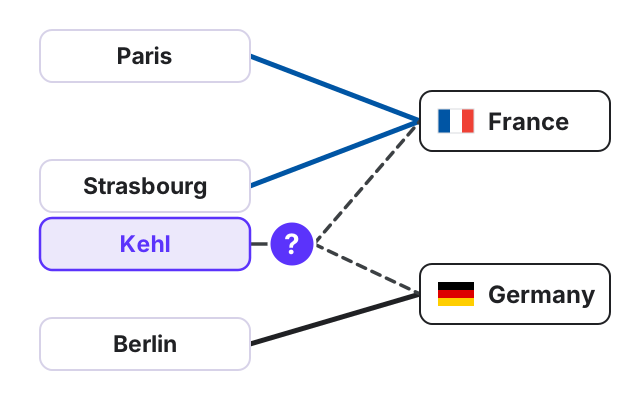
人類透過眼睛裡的三種視錐細胞,把棕色看成紅、綠、藍的組合。Prereasoner 也是用同樣的方式訓練的。它的維度以 schema.org 的屬性命名,例如國家和貨幣。所以,問題和答案都能追溯到我們模型中的這些屬性。
不可預測
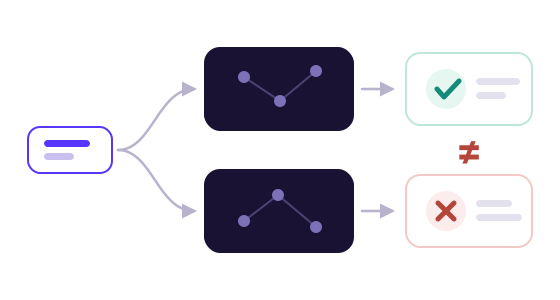
生成式 AI 會預測下一個最可能出現的字。它第一次可能選這個字,第二次選另一個字。這讓聊天機器人顯得像人。但在財務計算中,這代表同一個問題可能回傳不同的數字。
可預測
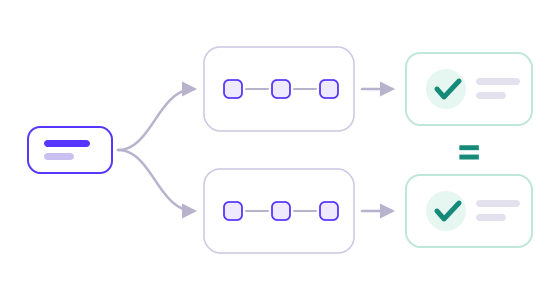
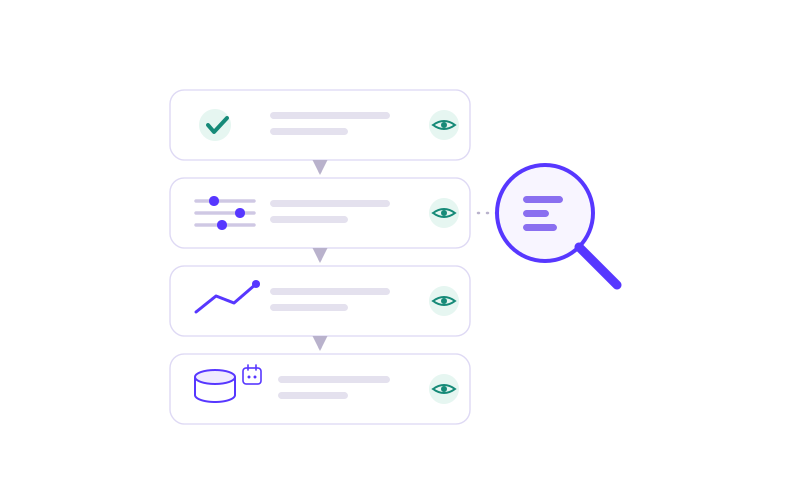
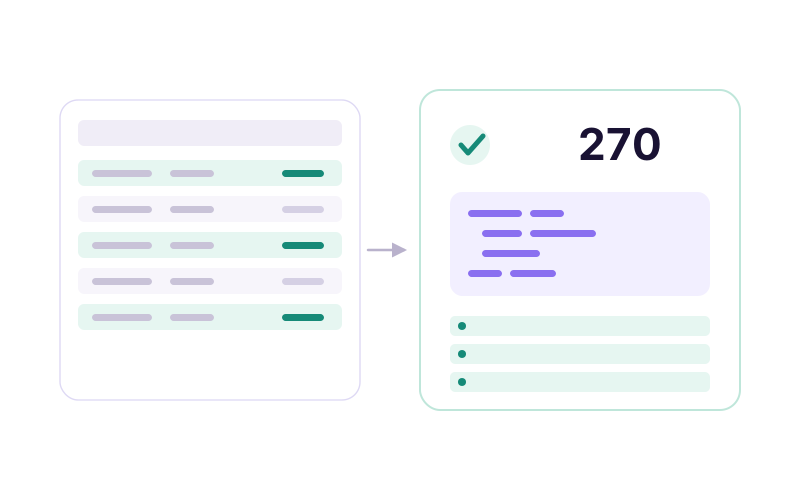
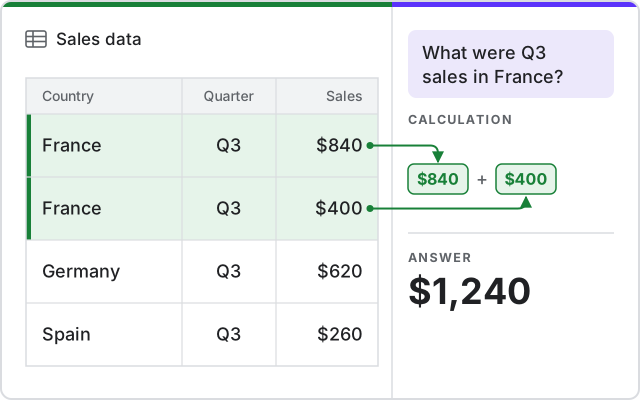
Prereasoner 會把問題轉換成具名維度,例如「FRANCE」中「SALES」的「SUM」。接著以確定性的方式轉換成 SQL 查詢或 Python 程式碼。執行時,由資料庫或程式碼算出數字。資料相同,您就會得到相同的查詢和相同的答案。